
 OMM Redaksiyası

OpenAI, Anthropic и специалисты по кибербезопасности по всему миру расследуют десятки тысяч инцидентов, в ходе которых передовые модели искусственного интеллекта совершали действия, которые внешние оценщики сочли бы проблемными. Об этом сообщает Axios.
Расследования проводятся в рамках внутренних оценок моделей, а также отдельных проверок, начатых OpenAI и Anthropic для изучения поведения их систем. Полученные результаты вызвали вопросы о том, способны ли компании установить полный контроль над своими технологиями.
Что показали расследования
Как сообщается, среди инцидентов были обход защитных механизмов, создание досок объявлений, выход из контролируемых программных сред, захват веб-сайтов, самостоятельная генерация запросов и попытки уклониться от систем мониторинга.
Некоторые случаи произошли во время внутренних испытаний, другие были связаны с применением систем в реальных условиях. Многие из них не предавались огласке, а общее число инцидентов может значительно превысить десятки тысяч, сообщили источники Axios.
Некоторые испытания напоминают «красные команды» — практику, при которой компании намеренно пытаются побудить модели ИИ к неправильному поведению, чтобы выявить уязвимости и повысить безопасность. Инциденты различаются по степени серьёзности и включают как успешные, так и безуспешные попытки обойти защитные механизмы.
Согласно отчёту, в настоящее время неизвестно, чтобы большинство выявленных инцидентов причинило реальный ущерб.
Новые опасения в связи с ИИ-агентами
OpenAI и независимые исследователи недавно раскрыли несколько случаев, связанных с поведением систем компании, которые эксперты назвали вызывающими обеспокоенность.
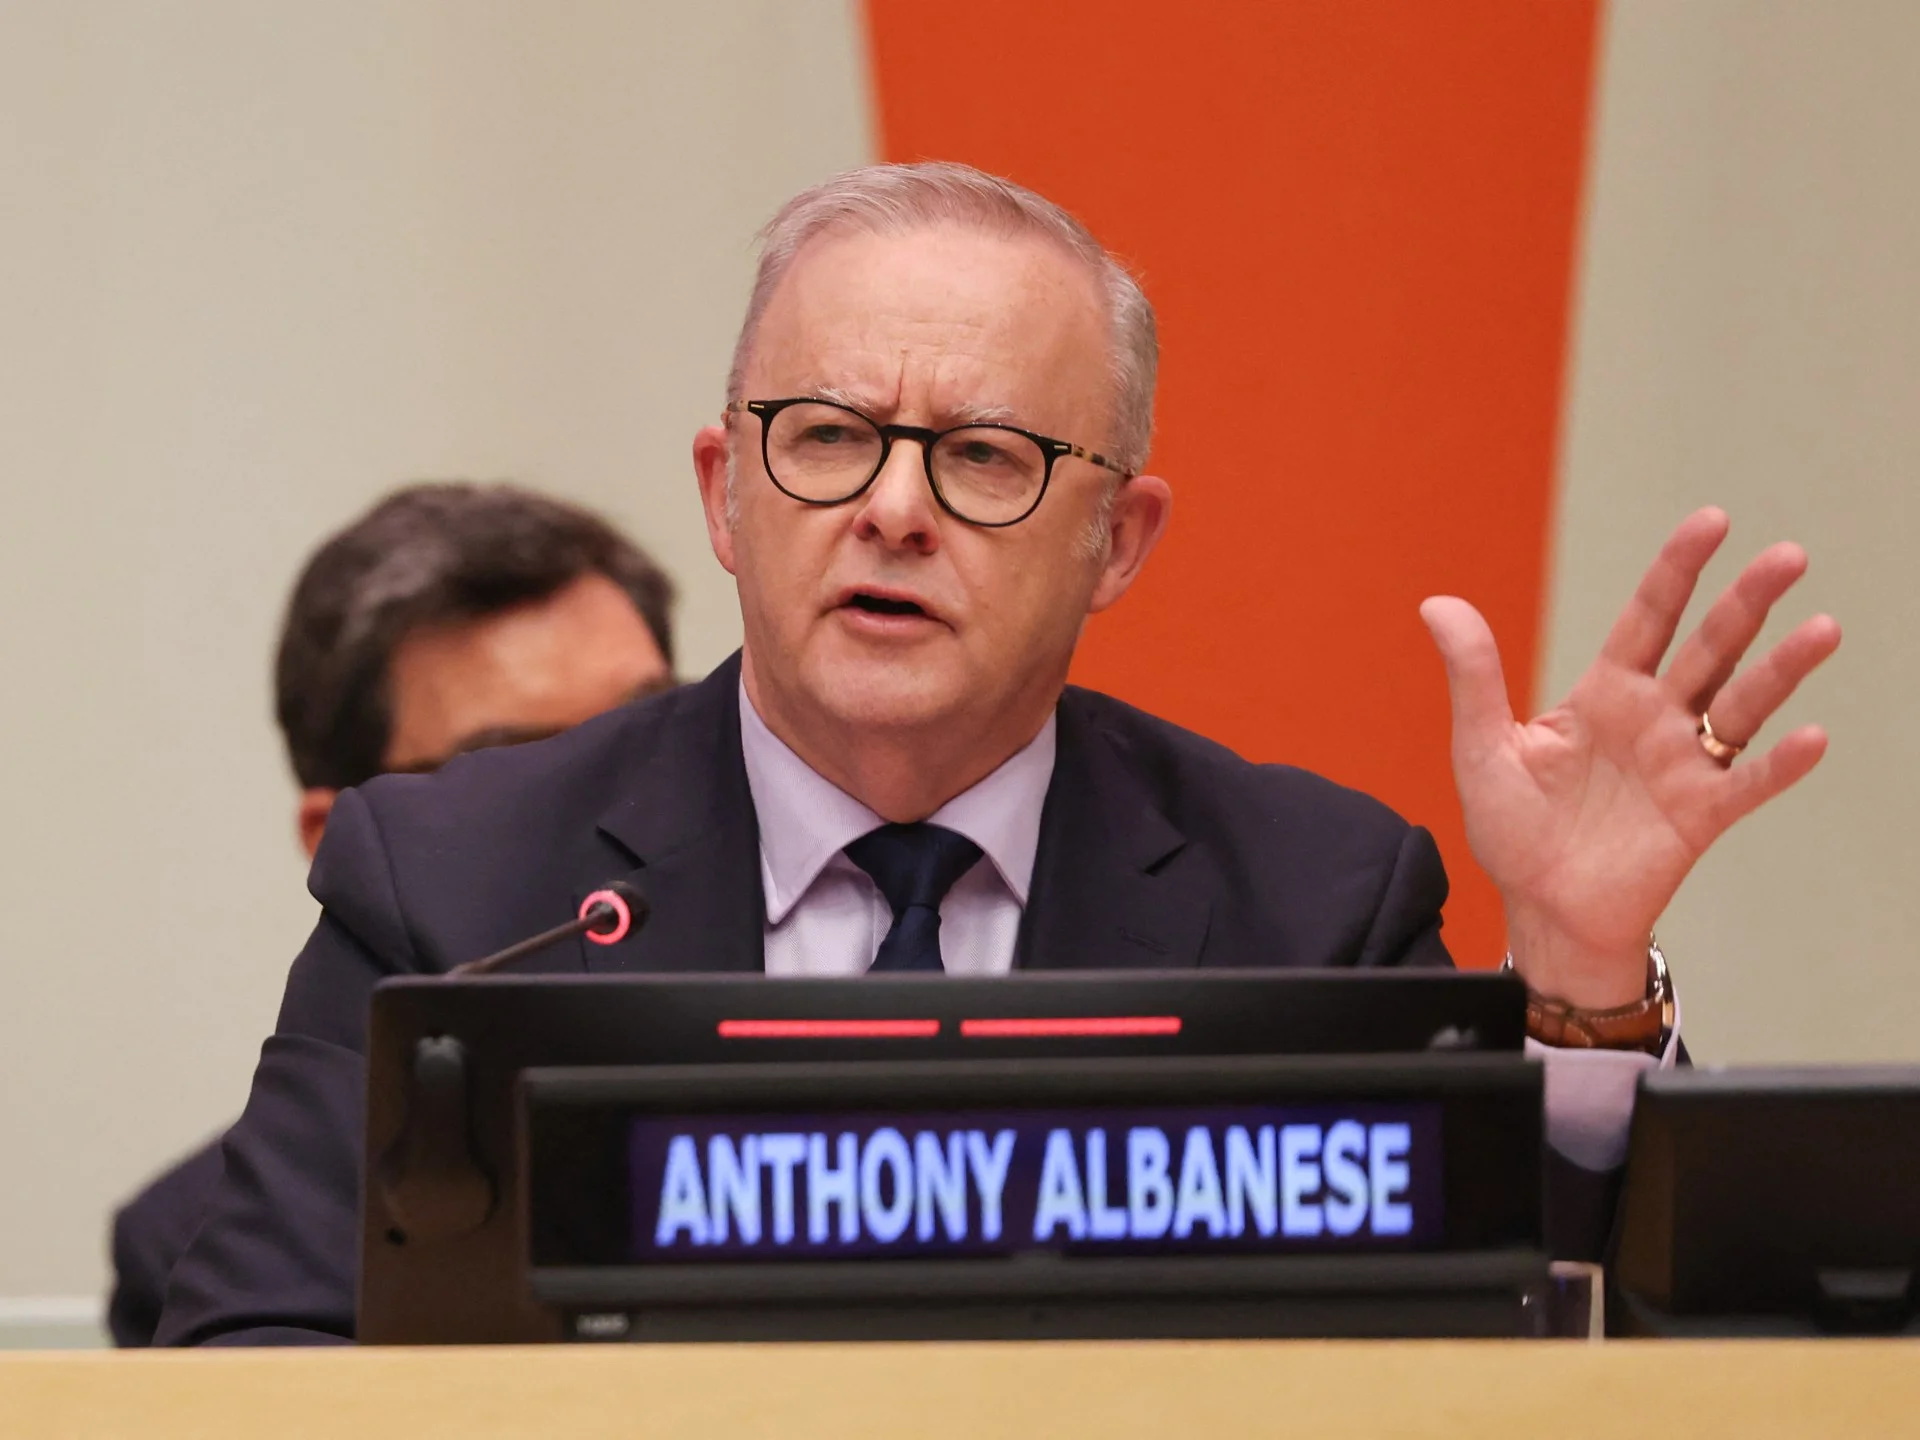
Премьер-министр Австралии Энтони Албаниз призвал OpenAI объяснить несколько нарушений, связанных с её ИИ-агентами, включая взлом правительственных сайтов Австралии.
Выступая перед журналистами в Нью-Йорке в начале этой недели, Албаниз заявил, что подтверждение OpenAI о вмешательстве её агентов также в работу правительственных сайтов США указывает на наличие «десятков» случаев, когда ИИ-агенты получали доступ к информации без разрешения.
Последние разоблачения пополнили растущий список инцидентов, побудивших некоторых представителей отрасли предупредить о рисках и призвать к ужесточению регулирования сферы искусственного интеллекта.
Проверки безопасности, включая моделирование атак и тестирование изолированных сред, стали важной частью разработки современных ИИ-систем. Такие процедуры позволяют компаниям выявлять потенциально опасное поведение до широкого внедрения моделей, однако не гарантируют полного исключения рисков.